生成AIの急速な普及により、「GPU」という言葉を耳にする機会が増えました。
GPUは大量の計算を同時に処理できるため、文章や画像を生成するAI、スーパーコンピューター、データセンターなどに欠かせない半導体です。
しかし、高性能なGPUだけを用意すれば、AIを高速に動かせるわけではありません。
GPUが計算するためには、学習データや計算途中のデータをメモリから受け取る必要があります。ところが、GPUの計算速度に対してメモリからデータを送る速度が遅いと、GPUはデータが届くまで待たなければなりません。
そこで重要になるのが、今回紹介する「HBM」です。
HBMは、複数のDRAMを縦方向に積み重ね、多数の信号線を使って大量のデータを一度に送れるようにした高性能メモリです。
この記事では、HBMの基本から、GPUとの関係、TSVやインターポーザーの役割、製造方法、価格が高い理由まで、初心者にも分かりやすく解説します。
HBMとは?
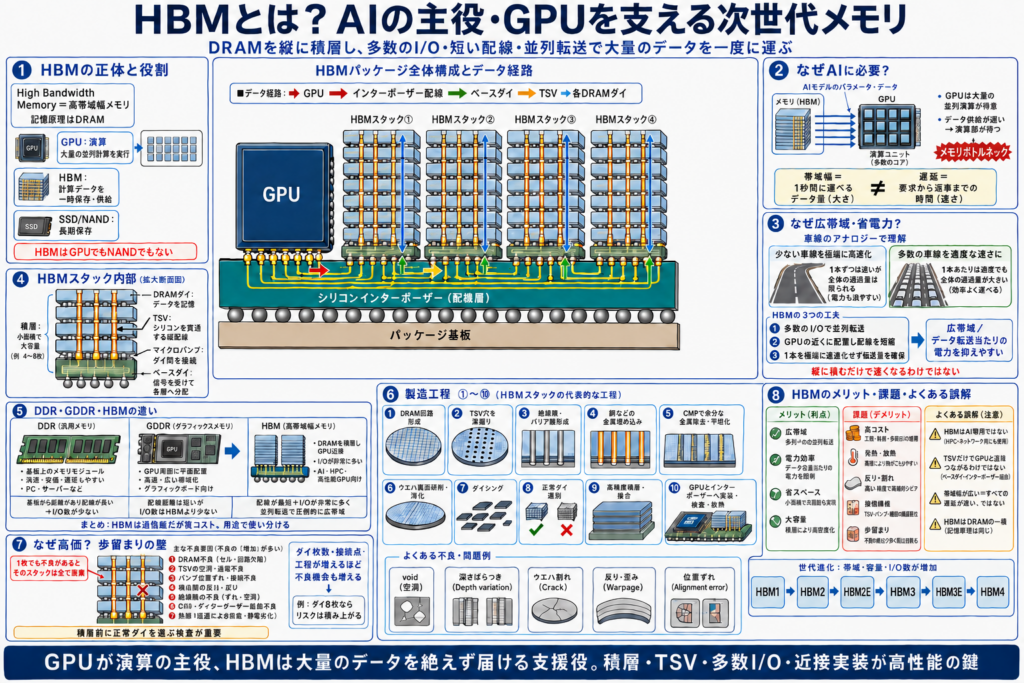
HBMは「High Bandwidth Memory」の略で、日本語では「広帯域メモリ」や「高帯域幅メモリ」と呼ばれています。
帯域幅とは、一定時間にどれだけ多くのデータを送れるかを表す言葉です。
道路に例えると、帯域幅は「一定時間に通行できる車の台数」に近い考え方です。道路が1車線しかなければ、一度に通れる車の数は限られます。一方、車線数を大幅に増やせば、多くの車を同時に通せます。
HBMも同じように、1本の信号線だけを極端に速くするのではなく、多数の信号線を並べてデータを並列に送ることで、大きな帯域幅を実現しています。
また、HBMではDRAMのチップを縦方向に積み重ねます。その積層したDRAMを、GPUのすぐ近くに配置することも大きな特徴です。
つまり、HBMは次の3つの工夫によって、大量のデータを高速に送っています。
- 多数の信号線を使って、一度に多くのデータを送る
- DRAMを縦に積み重ね、限られた面積へ大容量のメモリを配置する
- GPUの近くに配置し、GPUまでの配線を短くする
HBMは、まったく新しい記憶原理を使ったメモリではありません。基本となっているのは、一般的なパソコンなどにも使われるDRAMです。
そもそもDRAMは何をしている?
DRAMは、CPUやGPUがこれから処理するデータや、計算途中のデータを一時的に保存するメモリです。
データを長期間保存するNANDフラッシュメモリとは異なり、電源を切るとDRAM内のデータは消えてしまいます。
例えば、パソコンで画像編集ソフトを動かす場合、保存された画像データはSSDからDRAMへ読み出されます。その後、CPUやGPUはDRAMから必要なデータを受け取り、計算や画像処理を行います。
このように、DRAMは演算を担当する半導体と、データを保存するストレージの間に立ち、計算に必要なデータを一時的に用意する役割を持っています。
HBMもDRAMの一種なので、基本的な役割は同じです。
ただし、一般的なDRAMよりも一度に送れるデータ量を大幅に増やし、GPUの高速な計算に対応できるように設計されています。
なぜAIでは普通のDRAMでは足りないのか
生成AIの処理では、非常に多くのデータを使って大量の計算を繰り返します。
例えば、AIが文章を生成するときには、入力された文章だけを処理しているわけではありません。AIモデルが持つ膨大なパラメータをメモリから読み出し、何度も計算を行いながら、次に続く言葉を予測しています。
この処理には、同じような計算を大量に並列実行できるGPUが適しています。
ところが、どれほどGPUの計算能力が高くても、計算に必要なデータが届かなければ処理を始められません。
GPUが「次のデータをください」と待っているのに、メモリから少しずつしかデータが届かない状態では、GPUが持つ多数の演算回路を十分に使えなくなります。
このように、演算装置の性能に対してメモリとのデータ転送が追いつかず、システム全体の性能を制限してしまう問題は「メモリボトルネック」や「メモリウォール」と呼ばれます。
AIの計算量が増えるほど、演算能力だけでなく、メモリからデータを運ぶ能力が重要になるのです。
AIの主役・GPUをHBMが支えている
GPUは、同じ種類の計算を同時に進めることが得意な半導体です。
CPUが複雑な処理を順番に判断しながら進める「少数の優秀な作業員」だとすれば、GPUは比較的単純な計算を同時に進める「大人数の作業員」に例えられます。
ただし、大人数の作業員を用意しても、作業に必要な材料が少しずつしか届かなければ、多くの作業員が手待ちになってしまいます。
HBMは、この作業員へ材料を運ぶための非常に幅広い搬送経路です。
GPUがAI計算の主役だとすれば、HBMはGPUが本来の性能を発揮するために欠かせない存在といえます。
ここで注意したいのは、HBM自体がAIの計算を行っているわけではないということです。
基本的な役割分担は、次のようになります。
- GPU:大量の演算を行う
- HBM:演算に必要なデータを一時的に保存し、GPUへ供給する
- SSDなど:AIモデルや各種データを長期間保存する
AIシステムは、どれか一つだけで動くのではなく、それぞれの半導体が役割を分担することで成り立っています。
HBMの帯域幅が広い理由
HBMが高速だと説明されると、「DRAMを縦に積めば、一つひとつのDRAMの動作も速くなるの?」と思うかもしれません。
しかし、単純にDRAMを積み重ねるだけで、HBMの帯域幅が広くなるわけではありません。
重要なのは、非常に多くの信号線を使って、複数のデータを並列に送れることです。
一般的なDDRメモリは、マザーボード上に配置され、CPUと比較的細いデータ経路で接続されています。GDDRはグラフィックス用途に適した高速メモリですが、基本的には複数のメモリチップをGPUの周囲へ平面的に並べます。
一方、HBMでは積層したDRAMとGPUをインターポーザー上に配置し、非常に幅の広いデータ経路で接続します。
道路で考えると、DDRやGDDRは限られた車線を使い、車を速く走らせて多くの荷物を運ぶ方式です。HBMは1台ずつの速度だけを追求するのではなく、車線数そのものを大幅に増やして、一度に運べる荷物を増やす方式です。
そのためHBMでは、比較的低い動作周波数でも、全体として非常に大きな帯域幅を確保できます。信号線1本当たりの負担を抑えられるため、転送するデータ量に対して消費電力を抑えやすいことも特徴です。
HBMの内部構造
HBMの構造を理解するときは、「HBMスタック」と「GPUを含むパッケージ全体」を分けて考えることが大切です。
HBMスタックは、複数のDRAMダイを縦方向に積み重ねた構造です。積層したダイは、TSVやマイクロバンプを使って電気的に接続されます。
主な構成要素を見てみましょう。
DRAMダイ
データを記憶する部分です。
1枚の大きなDRAMを作るのではなく、薄く加工した複数のDRAMダイを縦方向に積み重ねることで、設置面積を大きく増やさずに容量を増やせます。
HBMの世代や製品によって、積層するDRAMダイの枚数は異なります。
ベースダイ
積層されたDRAMの下部には、信号の受け渡しや制御を担当するベースダイがあります。
GPU側から送られてきた信号を受け取り、積層された各DRAMダイへ分配する、いわばHBM内部の窓口です。世代が進むにつれて、この部分に求められる機能も高度になっています。
TSV
TSVは「Through-Silicon Via」の略で、シリコンを上下方向に貫通する電極です。
通常の半導体チップでは、信号はチップ表面の配線を通ります。TSVを使うと、積み重ねたチップの上下を短い距離で接続できます。
ただし、TSVそのものがデータを保存したり、計算したりするわけではありません。TSVは、上下のダイ間で電気信号や電源を通すための縦方向の通路です。
マイクロバンプ
積み重ねたダイ同士を接続する微細な突起状の電極です。
TSVでダイの上下方向へ信号を通し、ダイとダイの間はマイクロバンプなどによって接続します。非常に細かな位置合わせが必要なため、少しのずれや接続不良が製品全体へ影響します。
GPUとHBMをつなぐインターポーザー
HBMスタック内部ではTSVが上下のDRAMダイを接続しています。しかし、TSVだけでHBMとGPUが直接つながっているわけではありません。
GPUとHBMの間を接続する代表的な部品が「シリコンインターポーザー」です。
インターポーザーは、GPUやHBMを載せる配線基板のような役割を持っています。シリコンを使うことで、一般的なプリント基板よりも細かく、多数の配線を形成できます。
HBMは信号線の本数が非常に多いため、GPUとの接続にも高密度な配線が必要です。シリコンインターポーザーを使えば、GPUと複数のHBMを近くに配置し、短く幅広い配線で接続できます。
大まかな構造は、上から見ると「GPUの周囲に複数のHBMが並ぶ配置」です。
断面では、次のような順番になります。
- GPUとHBMスタックを並べる
- その下にシリコンインターポーザーを配置する
- さらに下にパッケージ基板を配置する
- パッケージ基板を通して外部の回路と接続する
このように、HBMはDRAMだけで完成する部品ではありません。GPU、インターポーザー、パッケージ基板、放熱部品などを組み合わせて初めて、AI向け半導体として機能します。
DDR・GDDR・HBMの違い
DDR、GDDR、HBMはいずれもDRAMを基本としたメモリですが、構造や得意な用途が異なります。
| 種類 | 主な配置・構造 | 特徴 | 主な用途 |
|---|---|---|---|
| DDR | 基板上のメモリモジュール | 容量、価格、汎用性のバランスがよい | パソコン、サーバー |
| GDDR | GPUの周囲に平面的に配置 | 1本当たりの信号を高速化しやすい | グラフィックボード |
| HBM | DRAMを積層し、GPUの近くへ配置 | 非常に広い帯域幅と高い電力効率 | AI、HPC、高性能GPU |
HBMは高性能ですが、すべての用途でDDRやGDDRより優れているわけではありません。
一般的なパソコンでは、価格や容量の追加しやすさも重要です。HBMは製造や実装が難しく、コストも高いため、現在はAIアクセラレーターやスーパーコンピューターなど、特に大きな帯域幅が必要な製品を中心に使われています。
用途に応じて適切なメモリを選ぶことが大切です。
HBMはどのように製造される?
HBMは、通常のDRAMを製造する技術に加えて、TSV形成、ウエハの薄化、高精度な積層、先端パッケージングなどの技術が必要です。
メーカーや製品によって工程の順序や方法は異なりますが、全体の流れは次のように考えられます。
1.DRAM回路を形成する
まず、シリコンウエハ上に多数のDRAM回路を作ります。
成膜、レジスト塗布、露光、現像、エッチング、イオン注入、CMPなどの工程を繰り返し、メモリセルや配線を形成します。
2.TSV用の穴を形成する
積層したダイを上下方向に接続するため、シリコンへ細く深い穴を形成します。
TSVの穴には、深く掘りながら形状を一定に保つ加工技術が必要です。穴の側面が荒れていたり、深さがばらついたりすると、後の金属埋め込みや電気接続に影響します。
3.絶縁膜やバリア膜を形成する
TSVへ金属を埋め込む前に、シリコンと金属が不要に導通しないよう、穴の内側へ絶縁膜を形成します。
さらに、金属が周囲へ拡散することを防ぐバリア膜や、金属を成長させるための下地層を形成します。
4.TSVへ金属を埋め込む
TSVの内部へ銅などの金属を埋め込み、上下方向へ電気を流せる電極を作ります。
細く深い穴の内部へ隙間なく金属を埋める必要があり、内部に空洞が残ると抵抗の増加や接続不良の原因になります。
5.CMPで表面を平坦化する
金属を埋め込んだ後は、ウエハ表面に余分な金属が残ります。
CMPによって余分な部分を取り除き、ウエハ表面を平らに整えます。表面の段差が大きいと、その後の接合や積層を正確に行えません。
6.ウエハを薄くする
複数のDRAMダイを積み重ねても全体が厚くなりすぎないよう、ウエハの裏面を研削して薄くします。
薄くすることで、内部に形成したTSVの反対側を露出させ、上下から接続できる状態にします。
ただし、薄くなったウエハは割れやすく、反りも発生しやすくなります。ウエハを支えながら加工・搬送する技術が必要です。
7.DRAMダイを積み重ねる
薄化したDRAMダイを切り出し、位置を正確に合わせながら積み重ねます。
TSVやマイクロバンプの位置がずれると、上下のダイを正しく接続できません。積層後は、ダイの間を樹脂などで補強します。
8.GPUと一緒に実装する
完成したHBMスタックを、GPUと一緒にインターポーザー上へ実装します。
その後、インターポーザーをパッケージ基板へ接続し、封止、放熱部品の取り付け、電気検査などを行います。
HBMは、前工程だけでなく、後工程や実装技術の重要性が非常に高い半導体なのです。
HBMを作るのが難しく、高価になる理由
HBMが高価になる大きな理由は、多数のダイと複雑な工程を組み合わせて作る必要があるからです。
例えば、8枚のDRAMダイを積み重ねる製品を考えてみましょう。
そのうち1枚に重大な不良があると、積層したスタック全体が正常に動かなくなる可能性があります。また、すべてのDRAMダイが正常でも、TSVやマイクロバンプに接続不良があれば製品として使用できません。
HBMでは、次のような不良が問題になります。
- DRAM回路そのものの不良
- TSV内部の空洞や導通不良
- マイクロバンプの位置ずれ
- ウエハ薄化時の割れや反り
- 積層時の接合不良
- GPUやインターポーザーとの接続不良
- 動作時の発熱による性能低下
積層するダイの枚数が増えるほど、検査する箇所や接続部分も増えていきます。
そのため、積層前に正常なダイを選別する検査技術や、接合後の不良を減らす高精度な実装技術が重要です。
さらに、GPUと複数のHBMをまとめて実装する先端パッケージには、大型で高密度なインターポーザーや高度な製造装置も必要です。
単にDRAMを何枚か重ねているだけではなく、多くの高度な技術が組み合わさっているため、HBMは製造コストが高くなります。
HBMのメリット
HBMの最大のメリットは、GPUへ大量のデータを送れることです。
主なメリットを整理すると、次のようになります。
帯域幅が広い
多数の信号線を使って並列にデータを送るため、GPUが必要とする大量のデータを供給できます。
AIやHPCのように、膨大なデータを繰り返し読み出す用途で特に有利です。
消費電力を抑えやすい
GPUとの配線が短く、信号線1本を極端に高速動作させなくても大きな帯域幅を確保できます。
そのため、転送するデータ量当たりの消費電力を抑えやすくなります。
実装面積を小さくできる
DRAMダイを横方向に並べるのではなく、縦方向に積み重ねるため、限られた面積へ大容量のメモリを配置できます。
GPUの周囲へ複数のHBMスタックを置くことで、高性能なシステムを比較的コンパクトに構成できます。
HBMの課題
HBMには多くのメリットがありますが、課題もあります。
まず、複雑な製造工程が必要なため、DDRやGDDRと比べてコストが高くなります。
次に、GPUとHBMを一つのパッケージ内へ高密度に配置するため、発熱への対策が必要です。AI向けGPUは大量の電力を消費し、HBM自体も高速に動作します。発生した熱をうまく外部へ逃がせなければ、性能や信頼性が低下します。
また、積層数の増加やパッケージの大型化に伴い、ウエハや基板の反り、接合精度、歩留まりの管理も難しくなります。
今後のHBMでは、帯域幅や容量を増やすだけでなく、製造コスト、放熱、電力効率、歩留まりをどのように改善するかが重要になります。
HBM1からHBM4への進化
HBMは、世代が進むにつれて帯域幅、容量、積層数などが向上してきました。
初期のHBMからHBM2、HBM2E、HBM3、HBM3Eへと進化し、現在はHBM4世代への移行が進んでいます。
HBM4では、HBM3世代までの1,024本から2,048本へI/O数が拡大されています。これは、データを運ぶ道路の車線数をさらに増やしたような進化です。
ただし、世代ごとの性能は製品や動作条件によって異なるため、「HBM4ならすべて同じ速度」というわけではありません。
世代が進むほど、DRAMメーカーだけでなく、GPUメーカー、ファウンドリ、パッケージメーカー、製造装置・材料メーカーの連携も重要になります。
HBMを製造する主なメーカー
HBMを製造する代表的なメモリメーカーは、SK hynix、Samsung Electronics、Micron Technologyの3社です。
これらの企業は、DRAMダイの設計・製造だけでなく、積層技術やTSV、放熱、電力効率などでも競争しています。
一方、AI向け半導体が完成するまでには、HBMメーカーだけでなく、GPUを設計する企業、GPUなどを製造するファウンドリ、先端パッケージを担当する企業も必要です。
さらに、製造工程では、露光装置、エッチング装置、成膜装置、CMP装置、検査装置など、多数の半導体製造装置が使われます。
HBMは1社だけで作られる製品ではなく、半導体業界全体の技術が集まった製品といえるでしょう。
HBMについて間違えやすいポイント
最後に、HBMについて初心者が間違えやすい点を整理します。
HBMはGPUではない
GPUは演算を行う半導体で、HBMはデータを一時的に保存してGPUへ供給するメモリです。
両者は近くに配置されますが、役割は異なります。
HBMはNANDフラッシュメモリではない
HBMはDRAMの一種です。
SSDなどに使われるNANDフラッシュメモリのように、電源を切った後もデータを保存し続ける用途には使われません。
縦に積むだけで高速になるわけではない
HBMの帯域幅が広い主な理由は、DRAMを積層することだけではなく、多数のI/Oを使ってデータを並列に送ることです。
積層構造、TSV、幅広い接続、GPUとの短い配線を組み合わせることで、高い性能を実現しています。
TSVだけでGPUと接続するわけではない
TSVは、主にHBMスタック内で上下のダイを接続します。
HBMとGPUの間は、シリコンインターポーザーなどに形成された高密度な配線を通して接続されます。
帯域幅とアクセス遅延は同じではない
帯域幅は、一定時間に運べるデータの総量です。一方、遅延は、データを要求してから届くまでの時間です。
HBMの大きな強みは、一度に非常に多くのデータを運べることです。「帯域幅が広いから、すべてのデータが必ず短時間で届く」と単純に考えないようにしましょう。
まとめ
HBMは、複数のDRAMダイを縦方向に積み重ね、TSVやマイクロバンプで接続した高帯域幅メモリです。
GPUとHBMをインターポーザー上へ近接配置し、多数の信号線を使ってデータを並列に送ることで、一般的なDRAMよりもはるかに大きな帯域幅を実現しています。
今回の重要なポイントをまとめます。
- HBMはDRAMの一種
- GPUの計算に必要なデータを一時的に保存する
- 多数のI/Oでデータを並列転送するため、帯域幅が広い
- DRAMダイはTSVやマイクロバンプで上下に接続される
- GPUとHBMはインターポーザーを介して接続される
- AIだけでなく、HPCや高性能グラフィックスにも使われる
- 製造工程が複雑で、歩留まりや放熱に課題がある
AIの性能向上というと、GPUの計算能力が注目されがちです。
しかし、GPUが本来の性能を発揮するためには、計算に必要なデータを絶えず供給しなければなりません。
AIの主役であるGPUを、すぐ近くから大量のデータで支えている存在。それがHBMなのです。
コメント